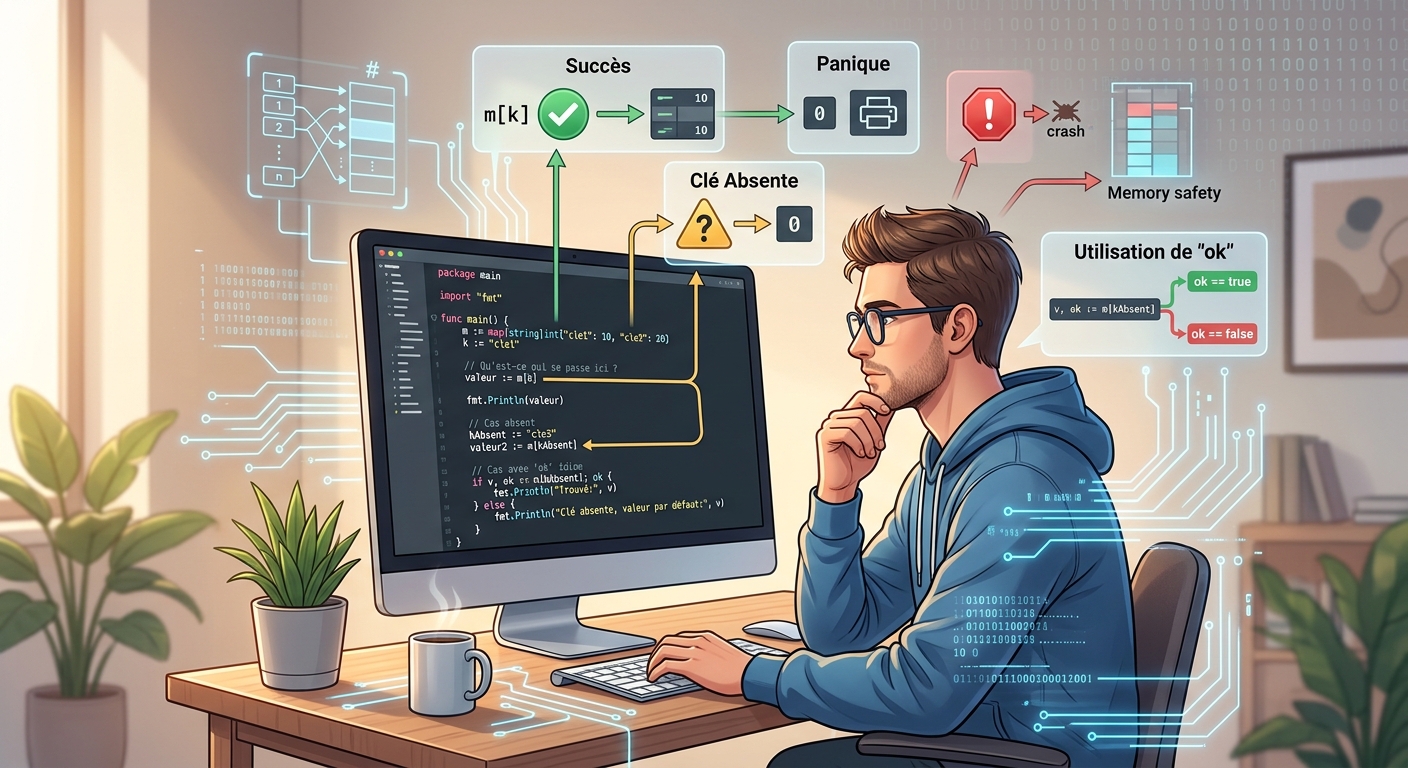
v, ok := m[k] tient sur une ligne.
Derrière, le runtime calcule un hash, choisit un emplacement, compare des octets de contrôle puis, seulement si tout concorde, compare la clé entière. Ce texte suit ce chemin, avec l’ancienne implémentation (hmap/bmap, celle que vous avez sous les yeux si vous tournez encore en dessous de Go 1.24) puis les Swiss Tables, qui l’ont remplacée par défaut depuis Go 1.24.
💡 Tout le code de la série est sur github.
Lire une clé absente ne panique jamais
Une map Go renvoie la valeur zéro du type quand la clé n’existe pas. Pas d’exception, pas d’erreur : m["absent"] donne 0 pour un int, "" pour une string. D’où l’idiome comma-ok pour distinguer “la clé vaut zéro” de “la clé n’existe pas”.
m := map[string]int{"a": 1}

v := m["b"]        // 0, aucune erreur
v, ok := m["b"]     // 0, false
v, ok = m["a"]       // 1, true
Écrire dans une map non initialisée (var m map[string]int), en revanche, panique. Une map nil se lit mais ne s’écrit pas.
Le hash a une graine, pour une raison précise
Chaque map reçoit à sa création une graine aléatoire (m.seed = uintptr(rand())), mélangée au hash de chaque clé. Sans elle, un attaquant qui connaît la fonction de hachage pourrait forger des clés qui tombent toutes dans le même emplacement et dégrader les lookups en scan linéaire : c’est le hash flooding. Rust fait le même choix côté standard, avec SipHash et une graine tirée à l’exécution.
L’ancienne implémentation : un bucket, huit cases, une gommette
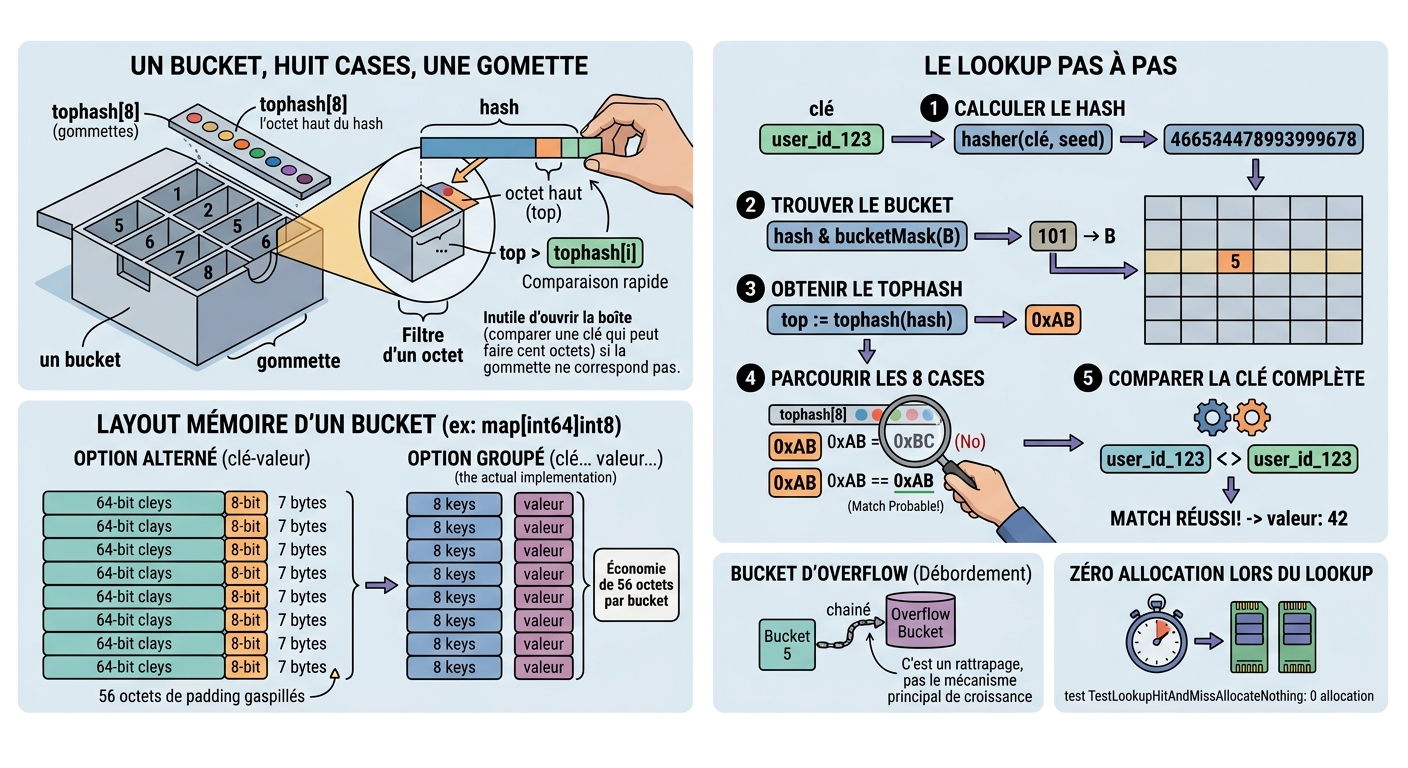
Jusqu’à Go 1.23 (encore accessible en 1.24 et 1.25 via GOEXPERIMENT=noswissmap), une map est un tableau de buckets. Chaque bucket contient huit emplacements et un petit tableau tophash[8] : l’octet haut du hash de chaque clé stockée.
Un lookup se déroule ainsi :
- calculer
hash := hasher(clé, seed); bucket := hash & bucketMask(B)— un masque sur les B bits bas, pas un modulo ;- prendre l’octet haut du hash,
top := tophash(hash); - parcourir les huit cases du bucket et comparer
topàtophash[i]; - seulement si ça correspond, comparer la clé complète.
L’octet top fait office de gommette collée sur chaque boîte : inutile d’ouvrir la boîte (comparer une clé qui peut faire cent octets) si la gommette ne correspond pas. Le filtre tient sur un octet et coûte une comparaison, la clé entière n’est comparée qu’en cas de correspondance déjà probable.
Le layout mémoire d’un bucket range les huit clés d’un bloc, puis les huit valeurs, plutôt que d’alterner clé-valeur-clé-valeur. Pour map[int64]int8, alterner paierait sept octets de padding par case ; grouper les clés puis les valeurs supprime ce padding, ce qui économise 56 octets par bucket.
Quand un bucket déborde, l’entrée en trop va dans un bucket d’overflow, chaîné au premier. C’est un rattrapage, pas le mécanisme principal de croissance.
Côté coût, un lookup réussi ou manqué n’alloue rien : testing.AllocsPerRun renvoie 0 dans les deux cas (test TestLookupHitAndMissAllocateNothing du dépôt d’exemples).
Swiss Tables : comparer huit octets d’un coup
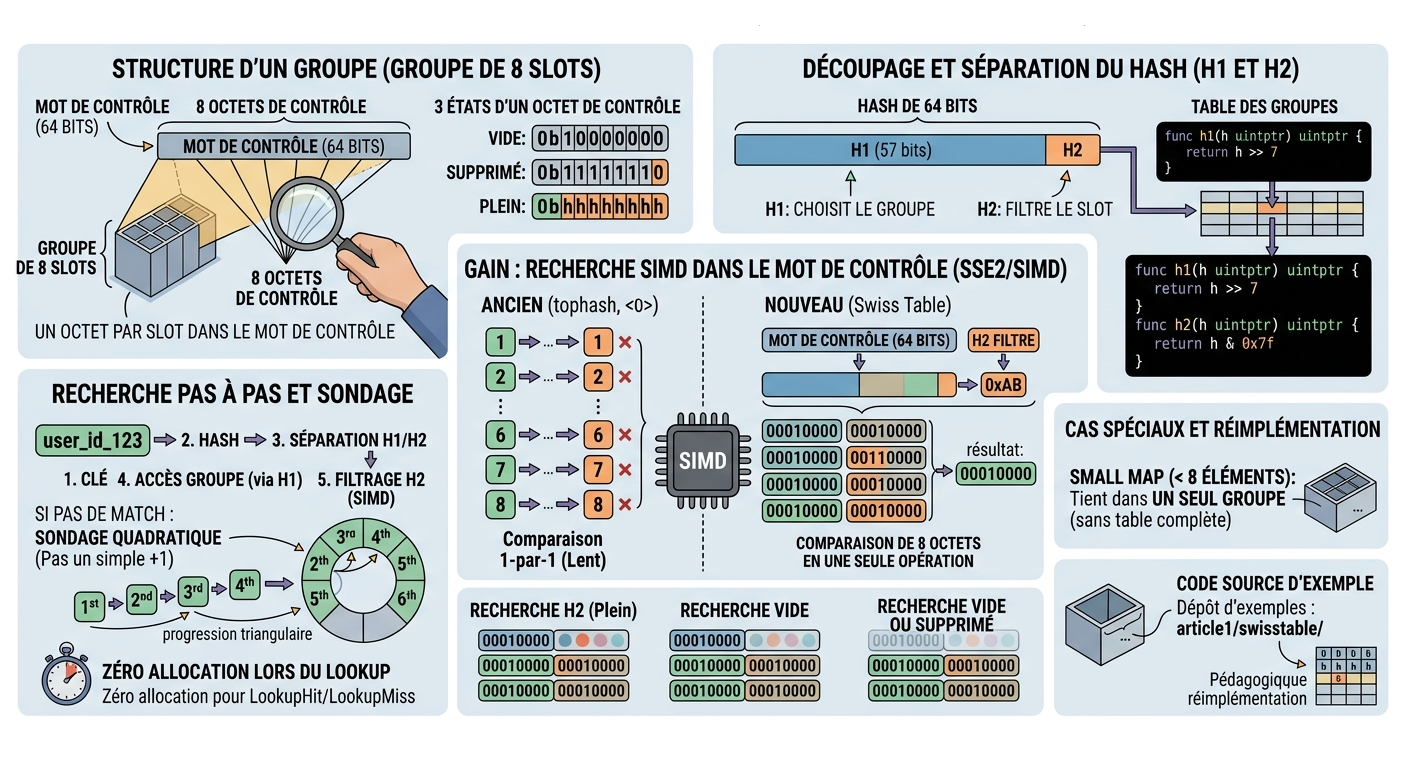
Depuis Go 1.24, l’implémentation par défaut change de stratégie sans changer l’idée du filtre par octet. Chaque table est découpée en groupes de huit slots (les tables elles-mêmes sont le sujet du prochain article). Chaque groupe a un mot de contrôle de 64 bits, un octet par slot.
Le hash de 64 bits se scinde en deux :
- H1, les 57 bits hauts, sert à choisir le groupe ;
- H2, les 7 bits bas, est stocké dans l’octet de contrôle du slot.
hash (64 bits)
+----------------------------------------------------+--------+
|                  H1 (57 bits)                       | H2 (7) |
+----------------------------------------------------+--------+
       choisit le groupe                          filtre le slot
Le gain vient de là : tophash testait les huit octets un par un, le mot de contrôle les teste d’un coup (SIMD/SSE2 sur AMD64, astuces de bits ailleurs). Chercher H2, un slot vide (0b10000000) ou un slot marqué supprimé (0b11111110) coûte une seule opération.
Si le groupe ne contient pas de correspondance, la recherche sonde le groupe suivant par sondage quadratique (une progression triangulaire, pas un simple +1). Une map d’au plus huit éléments tient dans un seul groupe : c’est le cas “small map”, sans table de hachage complète à côté.
Le découpage du hash tient en deux fonctions dans internal/runtime/maps/map.go (Go 1.27.1) :
// Extracts the H1 portion of a hash: the 57 upper bits.
// [...]
func h1(h uintptr) uintptr {
	return h >> 7
}

// Extracts the H2 portion of a hash: the 7 bits not used for h1.
//
// These are used as an occupied control byte.
func h2(h uintptr) uintptr {
	return h & 0x7f
}
Et les trois états d’un octet de contrôle, dans group.go :
//	  empty: 1 0 0 0 0 0 0 0
//	deleted: 1 1 1 1 1 1 1 0
//	   full: 0 h h h h h h h  // h represents the H2 hash bits
Une réimplémentation pédagogique de ce filtre H2, avec ses propres tests, vit dans le dépôt d’exemples (article1/swisstable/) — pas le code du runtime, une version simplifiée pour suivre le raisonnement pas à pas.
Ce qui change pour vous, concrètement
Le comportement observable de m[k] ne change pas d’une implémentation à l’autre. Ce qui change, c’est le coût par lookup : un test par octet contre un test sur huit octets d’un coup. Si vous êtes sur Go 1.24+, vous tournez déjà sur les Swiss Tables sans rien faire. Si un profil montre des maps chaudes en Go 1.23 ou avant, le blog officiel Go annonce jusqu’à 60 % de gain sur des microbenchmarks ciblés, et environ 1,5 % de CPU en moyenne géométrique sur des applications complètes. Upgrader peut réduire le coût, à mesurer sur le cas réel, sans changer une ligne de code métier.
La question qui reste ouverte : comment une map avec un bucket de huit cases stocke mille entrées sans que chaque lookup traverse une chaîne d’overflow interminable ? C’est le sujet du prochain article, avec les seuils de croissance et le coût d’un rehash.