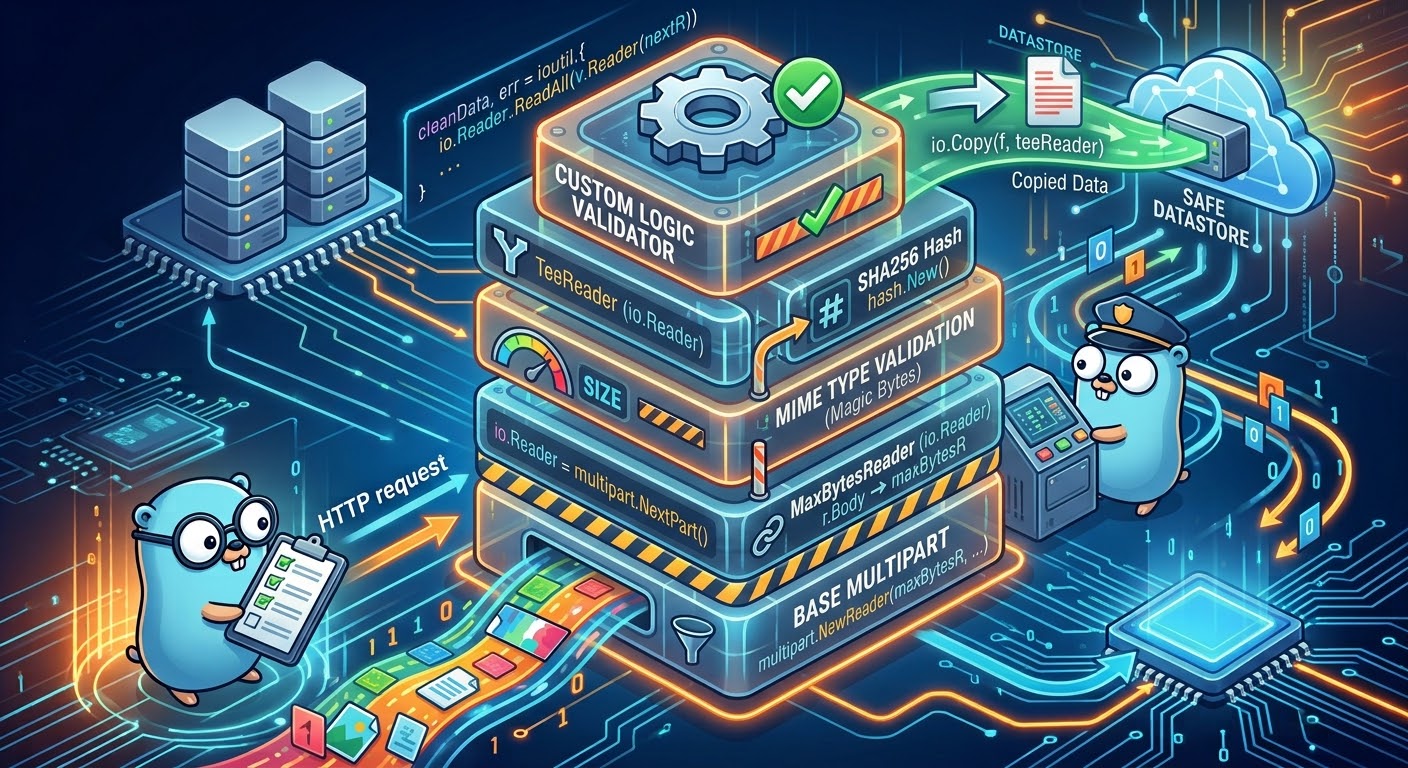
Dans l’article précédent, le corps de la requête n’est plus chargé en mémoire : MaxBytesReader[1] pose la limite, MultipartReader parcourt les parts une par une. Un gros fichier ne fait plus tomber le service. Il reste un problème plus discret :
on écrit sur disque un fichier dont on ne connaît ni le vrai contenu, ni le nom fiable.
Le Content-Type envoyé par le client se règle en trois clics dans n’importe quel outil HTTP. Le Part.FileName()[2] arrive tel quel, sans aucune vérification.
On ferme ces deux points en ajoutant des étages au pipeline de lecture, plutôt que des vérifications éparpillées dans le handler.
🧱 Le pipeline complet
Chaque étage ne connaît que Read(p []byte) (int, error)[3] ce qui nous permet de les empiler sans que l’un sache ce que fait l’autre.
nextFilePart précède le premier étage : il avance jusqu’à une part qui porte un nom de fichier. Sans lui, un champ de formulaire arrivé en premier serait pris pour le fichier.
Chaque ligne du code ci-dessous correspond à une boîte du schéma :
r.Body = http.MaxBytesReader(w, r.Body, maxUploadSize)
reader, _ := r.MultipartReader()
part, _ := nextFilePart(reader)
br := bufio.NewReader(part)
hashed := NewHashingReader(br)
_, err := io.Copy(dst, hashed)
Tous les étages sauf le hash viennent de la bibliothèque standard.
Les sections suivantes détaillent le sniffing, le hash et le nom de stockage, puis le handler complet les assemble.
🔍 Peek(512), pas Read, pas Seek
http.DetectContentType regarde au plus 512 octets et applique l’algorithme de sniffing WHATWG[4]. Sans signature reconnue, il répond application/octet-stream.
Ce n’est pas une erreur, juste une absence de réponse.
Le piège est dans la façon de récupérer ces 512 octets : le contrat de io.Reader autorise Read à en rendre moins, et l’extrait est alors tronqué. Même complet, il est consommé : ni Read ni io.ReadFull ne le rendent à l’étage suivant.
Certains tutoriels détectent puis rembobinent avec file.Seek(0, io.SeekStart). Cela fonctionne avec FormFile, qui fabrique un *os.File ou un buffer mémoire. Un *multipart.Part en flux n’a pas de Seek.
La solution est bufio.Reader.Peek(512)[5] (la constante sniffLen dans le code) qui lit les octets dans son tampon interne sans les consommer. La lecture suivante les retrouve intacts.
Comment Peek lit sans consommer ?
Un bufio.Reader contient un tampon (4096 octets par défaut) et deux marqueurs :
r, la position de lecture ;-
w, la position d'écriture.
r et w ont été reçus du flux mais pas encore rendus à l'appelant.
Peek(512) procède en trois temps :
- S'il y a moins de 512 octets disponibles, il lit dans le flux sous-jacent, autant de fois que nécessaire, jusqu'à en disposer ou rencontrer une erreur.
- Il renvoie une vue sur
buf[r : r+512], ou sur ce qui est disponible si le flux s'arrête avant. - Il ne fait pas avancer
r.
Les octets sont donc sortis du flux et se trouvent dans le tampon, mais l'appelant n'a encore rien consommé. Le Read suivant rend d'abord ces mêmes octets, puis déplace r. Consommer signifie faire avancer r : Read le fait, Peek non.
Trois limites :
Peek(n)renvoiebufio.ErrBufferFullsindépasse la taille du tampon.- La vue renvoyée n'est valable que jusqu'à la lecture suivante.
- Si le flux se termine avant 512 octets,
Peekrenvoie ce qu'il a lu avecio.EOF.SniffTypetraite ce cas comme normal.
// internal/upload/sniff.go
// sniffLen is the number of bytes http.DetectContentType looks at.
const sniffLen = 512

// ErrUnsupportedType is returned by ValidateType when the sniffed content
// type isn't in AllowedTypes.
var ErrUnsupportedType = errors.New("unsupported content type")

// AllowedTypes maps each MIME type accepted after content sniffing to the
// file extension used when storing it. A single map keeps the allow-list and
// the extension table from drifting apart.
var AllowedTypes = map[string]string{
	"image/png":       ".png",
	"image/jpeg":      ".jpg",
	"application/pdf": ".pdf",
}

// SniffType peeks at the first sniffLen bytes of br without consuming them and
// returns the MIME type detected by http.DetectContentType.
func SniffType(br *bufio.Reader) (string, error) {
	head, err := br.Peek(sniffLen)
	if err != nil && !errors.Is(err, io.EOF) {
		return "", fmt.Errorf("peek content: %w", err)
	}
	return http.DetectContentType(head), nil
}

// ValidateType returns ErrUnsupportedType if contentType isn't in AllowedTypes.
func ValidateType(contentType string) error {
	if _, ok := AllowedTypes[contentType]; !ok {
		return fmt.Errorf("%w: %s", ErrUnsupportedType, contentType)
	}
	return nil
}
Seule la liste blanche des types acceptés bloque réellement un fichier. DetectContentType écarte les cas grossiers (un exécutable renommé en .png ne passe pas pour un PNG), mais son catalogue de signatures est limité.
Un fichier qui commence bien puis dérape passe sans être repéré.
Il faut le voir comme un filtre et pas une garantie.
🔐 Le hash au passage, sans deuxième lecture
Une fois le type accepté, on veut souvent une empreinte du fichier, pour la déduplication ou l’intégrité. io.TeeReader[6] évite une deuxième lecture : chaque octet lu par l’étage suivant est aussi écrit dans le hash.
// internal/upload/hash.go
type HashingReader struct {
	io.Reader
	sum hash.Hash
}

// NewHashingReader wraps r with io.TeeReader so reads from the returned
// HashingReader also feed a sha256 hash.
func NewHashingReader(r io.Reader) *HashingReader {
	h := sha256.New()
	return &HashingReader{Reader: io.TeeReader(r, h), sum: h}
}

// Sum returns the hex-encoded sha256 digest of everything read so far. Call
// it only after the wrapped reader has reached EOF.
func (hr *HashingReader) Sum() string {
	return hex.EncodeToString(hr.sum.Sum(nil))
}
Le hash n’est disponible qu’à la fin de io.Copy, une fois tout le flux consommé. Pour vérifier l’intégrité avant d’accepter le fichier, il faut donc comparer après coup et supprimer le fichier s’il ne correspond pas.
📁 Le nom qui ne sort jamais du dossier
Part.FileName() applique filepath.Base sur ce que le client envoie, conformément à la RFC 7578. Le résultat dépend de la plateforme. Sous Unix, ..\..\win.ini n’est pas un chemin reconnu : filepath.Base le laisse passer tel quel, et un nom de traversée de répertoire arrive intact dans le handler.
On n’assainit pas ce nom : on ne s’en sert ni comme nom de fichier, ni pour l’extension. Le nom de stockage vient de 16 octets aléatoires (crypto/rand) en hexadécimal, l’extension du type détecté via AllowedTypes. Sans cela, un PNG envoyé sous le nom evil.html serait stocké en .html, prêt à être resservi comme une page HTML.
// internal/upload/store.go
const storedNameBytes = 16

// GenerateStoredName returns a random, collision-resistant filename for
// storing an upload. The extension comes from the sniffed contentType, via
// AllowedTypes, never from the client-supplied name: a PNG uploaded as
// "evil.html" is still stored with a ".png" extension, so a mismatched
// client-chosen name can't turn into a file served with the wrong type.
func GenerateStoredName(contentType string) (string, error) {
	ext, ok := AllowedTypes[contentType]
	if !ok {
		return "", fmt.Errorf("generate stored name: %w: %q", ErrUnsupportedType, contentType)
	}

	buf := make([]byte, storedNameBytes)
	if _, err := rand.Read(buf); err != nil {
		return "", fmt.Errorf("generate stored name: %w", err)
	}
	return hex.EncodeToString(buf) + ext, nil
}

// CreateInRoot creates name for writing inside root. Unlike a plain
// os.Create with a path built from user input, a name that tries to escape
// root (e.g. "../../evil.png") fails here instead of landing outside the
// upload directory.
func CreateInRoot(root *os.Root, name string) (*os.File, error) {
	f, err := root.Create(name)
	if err != nil {
		return nil, fmt.Errorf("create %s under root: %w", name, err)
	}
	return f, nil
}os.Root[7], disponible depuis Go 1.24, referme la boucle :
toute écriture hors du dossier confié échoue avec une erreur explicite (« path escapes from parent »), même si un nom malveillant s’était glissé jusque-là.
🧩 Le handler assemblé
Le handler se trouve dans internal/upload/pipeline.go.
Il enchaîne le sniffing, la validation, la génération du nom, l’écriture et le hash.
// internal/upload/pipeline.go (extrait de newPipelineHandler)
br := bufio.NewReader(part)
contentType, err := SniffType(br)
if err != nil {
	http.Error(w, "cannot read file header", http.StatusBadRequest)
	return
}
if err = ValidateType(contentType); err != nil {
	http.Error(w, "unsupported file type", http.StatusUnsupportedMediaType)
	return
}

storedName, err := GenerateStoredName(contentType)
if err != nil {
	http.Error(w, "cannot generate name", http.StatusInternalServerError)
	return
}

dst, err := CreateInRoot(root, storedName)
if err != nil {
	http.Error(w, "cannot store file", http.StatusInternalServerError)
	return
}

hashed := NewHashingReader(br)
var source io.Reader = hashed
// …

if _, err = io.Copy(dst, source); err != nil {
	cleanupFailedUpload(root, dst, storedName, logf)

	var maxErr *http.MaxBytesError
	if errors.As(err, &maxErr) {
		http.Error(w, "file too large", http.StatusRequestEntityTooLarge)
		return
	}
	http.Error(w, "upload failed", http.StatusInternalServerError)
	return
}

if err = dst.Close(); err != nil {
	cleanupFailedUpload(root, nil, storedName, logf)
	http.Error(w, "upload failed", http.StatusInternalServerError)
	return
}

w.Header().Set("Content-Type", "text/plain; charset=utf-8")
//nolint:gosec // G705: served as text/plain
fmt.Fprintf(w, "stored %s as %s (sha256 %s)\n", part.FileName(), storedName, hashed.Sum())
dst.Close() est vérifié, et toute erreur passe par cleanupFailedUpload. Cette fonction ferme le fichier avant de le supprimer :
// internal/upload/pipeline.go
func cleanupFailedUpload(root *os.Root, dst *os.File, storedName string, logf Logf) {
	if dst != nil {
		if cerr := dst.Close(); cerr != nil {
			logf("close partial upload %s: %v", storedName, cerr)
		}
	}
	if rmErr := root.Remove(storedName); rmErr != nil && !errors.Is(rmErr, fs.ErrNotExist) {
		logf("cleanup partial upload %s: %v", storedName, rmErr)
	}
}
⚠️ Conclusion - les pièges à éviter
Part.FileName()n’est pas un chemin sûr.
Le nom de stockage est généré côté serveur. Le nom d’origine peut être conservé comme métadonnée, à condition de le traiter comme une entrée non fiable.- Le
Content-Typedu client ne prouve rien, ni dans l’en-tête HTTP ni dans le multipart : c’est une déclaration, pas un fait. - Le fichier partiel n’est pas nettoyé tout seul.
RemoveAll()[8] ne vide que le formulaire multipart, pas ce que le handler a écrit : d’oùcleanupFailedUpload. mime/multiparta ses propres limites anti-DoS.
Depuis CVE-2023-24536[9],ReadFormplafonne à 1000 parts, et chaque part, donc aussi la nôtre, à 10 000 en-têtes. CVE-2022-41725[10] visait la mémoire et les fichiers temporaires deReadForm. La taille totale du fichier reste à borner soi-même, viaMaxBytesReader.
io.Copy ne dit rien de sa progression et ne sait pas qu’on voudrait l’arrêter.
Nous verrons comment gérer cela dans un prochain article.
🧑💻 Le code complet de la série est sur github.
🔗 Liens
http.MaxBytesReadermime/multipart, typePartet RFC 7578io.Readeret Erwin Hermanto, Implementing a Custom io.Reader for Streaming Large Fileshttp.DetectContentTypeet MIME Sniffing Standard (WHATWG)bufio.Reader.Peekio.TeeReaderos.Rootet Go 1.24 Release Notesmultipart.Form.RemoveAll- GO-2023-1705 (CVE-2023-24536)
- GO-2023-1569 (CVE-2022-41725)