Dans l’article précédent, on a réglé la pagination avec du keyset. Reste un autre problème, plus fin : un client qui veut tout le dataset une première fois, puis seulement ce qui a changé depuis. Le keyset ne répond qu’à la première partie.
🔑 Premier parcours : une clé, pas un horodatage
Pour un export complet, triez sur une clé immuable et totale : chaque ligne présente au début du parcours doit avoir une place fixe dans l’ordre, du début à la fin.
SELECT * FROM transactions
WHERE id > $1
ORDER BY id
LIMIT $2;
Un id auto-incrémenté fait ça très bien, un UUID aussi.
Le piège avec un UUIDv4 est le suivant:
Une ligne insérée pendant le parcours atterrit à une position aléatoire par rapport au curseur : avant, elle est manquée, après, elle est vue par hasard.
A l’inverse, un UUIDv7 ou une séquence placent les nouvelles lignes en fin d’ordre.
Cela étant dit, même avec une séquence, la garantie « vue une fois et une seule » a une frontière :
elle vaut pour les lignes présentes au début et non supprimées en route, pas pour celles insérées en route. Les mises à jour, elles, sont lues dans l’état où elles se trouvent au moment où leur page passe.
🕳️ Le piège de la visibilité
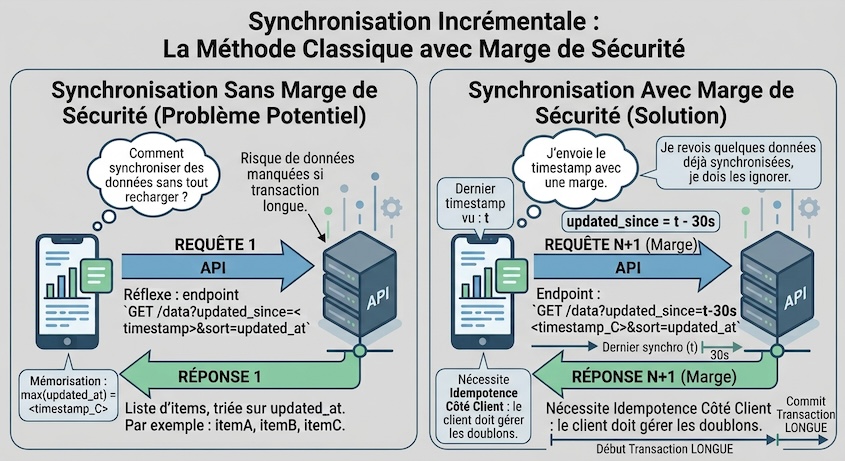
Pour la synchronisation incrémentale, le réflexe est un endpoint ?updated_since=<timestamp> trié sur updated_at. Le client garde le plus grand updated_at vu et le renvoie au tour suivant.
updated_at est valorisé par now(), qui renvoie l’heure de début de transaction, pas l’instant de l’écriture ni celui du commit. Sa visibilité, elle, arrive au COMMIT. Une transaction longue peut donc commencer à 10:00:00 et ne committer qu’à 10:00:09, pendant qu’une autre transaction commence et committe une ligne à 10:00:03.
Le client synchronise à 10:00:05, voit la ligne de T2, pose son watermark à 10:00:03. Quand T1 committe, sa ligne apparaît avec un updated_at antérieur au watermark.
⚠️ Elle ne sera plus jamais renvoyée 😱.
Remplacer updated_at par un numéro de séquence ne règle rien : nextval() réserve sa valeur à l’INSERT, pas au COMMIT : deux transactions peuvent tirer 41 puis 42 et committer dans l’ordre inverse.
un curseur
seq > dernier_vua exactement le même trou qu’updated_at.
Le dépôt d’exemple reproduit ce scénario contre un vrai Postgres (testcontainers-go) : TestNaiveCursorLosesRowFromTransactionCommittedAfterSync montre la ligne de T1 perdue pour toujours avec un curseur position > $1.
🛠️ La parade : reculer le watermark
Reculez le watermark d’une marge supérieure à la durée maximale d’une transaction (updated_since = watermark - 30s). Le client revoit quelques lignes imposant l’idempotence côté client.
La marge doit couvrir la durée totale d’une transaction, pas le temps entre écriture et commit.
ℹ️ Ni
statement_timeoutniidle_in_transaction_session_timeoutne bornent cette durée totale. Seultransaction_timeout(PostgreSQL 17+) le fait, sauf surcharge par rôle ou session.
🗑️ Les suppressions, et ce que font les grands acteurs
Un curseur updated_since ne voit jamais un DELETE : la ligne a juste disparu. Il faut des tombstones ou un soft delete traité comme une mise à jour.
Microsoft Graph combine les deux besoins dans son flux delta : jeton deltaLink opaque, marqueur @removed pour les suppressions. Google Calendar inclut toujours les entrées supprimées dans sa synchro incrémentale, au client de les retirer de son stockage ; son nextSyncToken expire lui aussi, avec un 410 explicite : le client repart de zéro plutôt que de deviner. Zendesk ne renvoie jamais la dernière minute sur ses exports de tickets, pour éviter les conditions de course. Stripe, plus radical, ne garde ses événements consultables que 30 jours.
📦 Au-delà de la synchro : le job d’export
Un parcours paginé, même corrigé, reste sans instantané : chaque page voit l’état de la base au moment où elle est lue, pas au moment où le parcours a commencé. Pour une vue cohérente sur plusieurs heures, il faut un job d’export : une transaction REPEATABLE READ ou un snapshot exporté (pg_export_snapshot), un fichier JSONL, une URL signée, comme Shopify. Le job tourne à son rythme, borné dans le temps, plutôt qu’une transaction ouverte au rythme du client : voir l’article sur les jobs asynchrones avec Postgres.
⚠️ Borné ne veut pas dire gratuit : tant qu’il tourne, ce job retient lui aussi l’horizon du vacuum.
En résumé
Un même endpoint de liste ne peut pas tout faire. Un écran qui feuillette des pages et un connecteur ETL qui aspire le dataset n’ont pas les mêmes besoins : donnez à chacun le mécanisme qui lui correspond.
- Récupérer tout le dataset une première fois : un parcours keyset sur une clé immuable, comme pour l’écran.
- Récupérer ensuite ce qui a changé : un curseur
updated_sincedont le watermark recule d’une marge plus longue que la plus longue transaction. - Obtenir une photo cohérente à un instant donné : pas une API de liste, mais un job d’export qui produit un fichier.
Crédits & Ressources
- Oskar Dudycz — How Postgres sequences issues can impact your messaging guarantees
- Anthony Accomazzo (Sequin) — Postgres sequences can commit out-of-order
- PostgreSQL docs — Date/Time Functions
- Microsoft Learn — Use delta query to track changes
- Google Calendar API — Synchronize resources efficiently
- Shopify — Perform bulk operations (queries)
- Zendesk — Using the Incremental Exports API
- PostgreSQL docs — System Administration Functions (pg_export_snapshot)
- Stripe — Events API