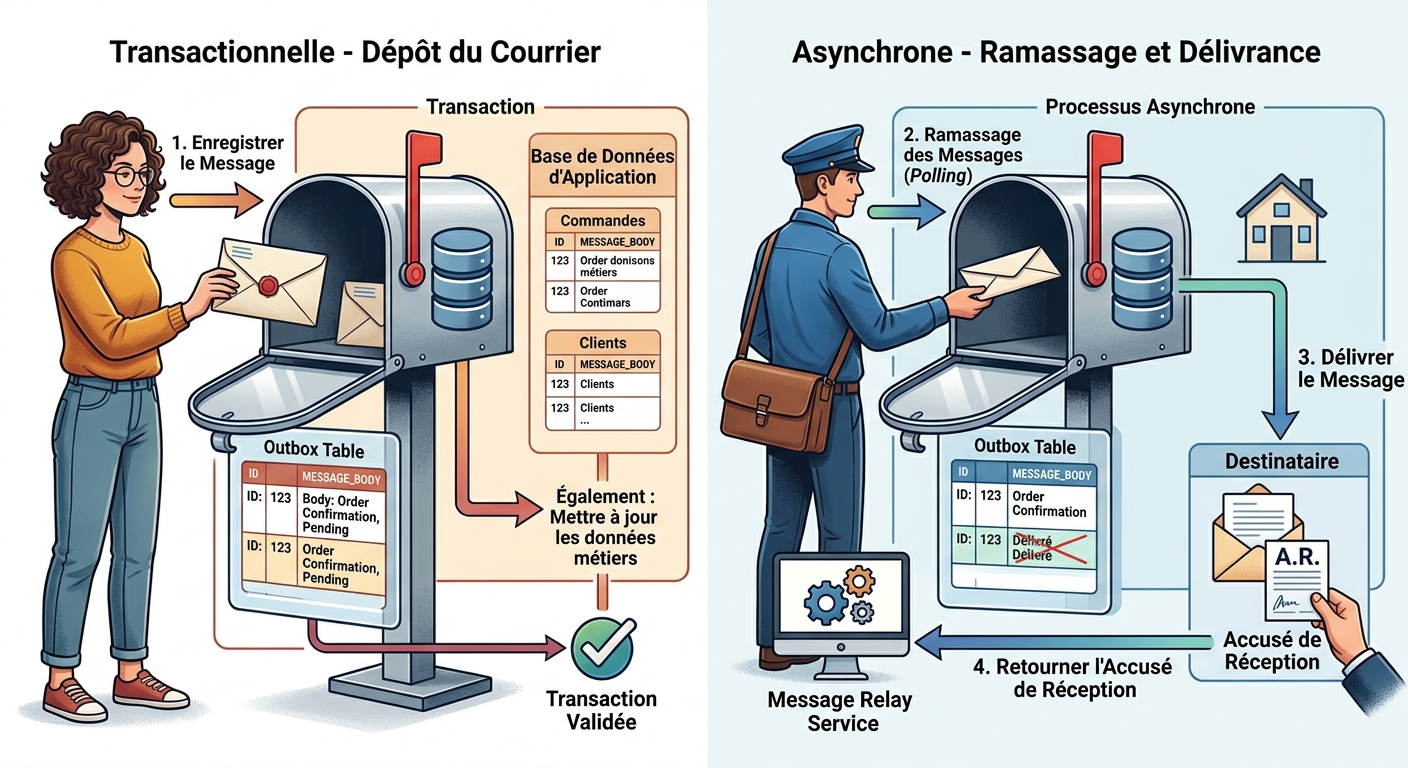
Un service écrit une ligne en base, puis publie un message sur RabbitMQ pour prévenir le reste du système. Deux opérations, deux systèmes, une seule illusion : qu’elles réussissent ou échouent ensemble. Ce sujet nous a occupés chez Stonal avant mars 2026. La table qui en est sortie tourne depuis sans incident. C’est encourageant, ce n’est pas une preuve : le volume reste modeste, environ 50 000 événements par jour, moins d’un par seconde en moyenne.
Le dual write ne se répare pas en changeant l’ordre
Écrire en base puis publier sur le broker n’est pas atomique. Le commit réussit et la publication échoue. Ou l’inverse, transaction annulée derrière. Ou le processus crashe entre les deux. Ou le broker accepte sans jamais confirmer.
Publier avant de committer ne résout rien, ça déplace le risque : notifier un événement qui n’existe pas encore en base. Aucun ordre d’exécution ne rend deux systèmes atomiques l’un envers l’autre. Il faut une transaction distribuée, rarement disponible avec un broker, ou renoncer à écrire dans les deux à la fois.
La solution : une seule écriture, un relay à part
L’outbox pattern écrit le message dans une table dédiée, dans la même transaction que le changement métier (voir Bien gérer ses transactions en base de données). Une transaction Postgres est atomique par construction : les deux lignes existent, ou aucune. Un processus séparé, le relay, lit ensuite la table, publie vers RabbitMQ, puis marque la ligne comme publiée.
Le prix :
- de la latence,
- de l’ at-least-once plutôt que de l’exactly-once.
Pourquoi at-least-one ❓
Le relay peut publier un message puis crasher avant d’enregistrer que c’est fait ; au redémarrage, il le republie 👉 doublon mais à minima, le message sera publié à minima une fois.
🚧 Conséquences
Le consommateur devra reconnaître ce doublon, sujet du deuxième article de la série.
CREATE TABLE IF NOT EXISTS outbox (
    id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    event_id UUID NOT NULL DEFAULT gen_random_uuid(),
    event_type TEXT NOT NULL,
    payload JSONB NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    published_at TIMESTAMPTZ
);

CREATE UNIQUE INDEX IF NOT EXISTS outbox_event_id_idx ON outbox (event_id);
CREATE INDEX IF NOT EXISTS outbox_pending_idx ON outbox (id) WHERE published_at IS NULL;
L’index partiel ne porte que sur les lignes encore à publier : le relay ne scanne jamais l’historique déjà envoyé. Les extraits Go qui suivent viennent d’un module qui compile et qui passe ses tests, où deux services, orders et shipping, s’échangent leurs événements via RabbitMQ.
event_type dit ce qui s’est passé, order.created, et sert directement de routing key. Le reste, identifiant de la commande compris, vit dans le payload.
// CreateOrder writes the order row and its outbox event in the same transaction: either both
// commit, or neither does — the outbox never lags behind the business state it describes.
func (s *PgStore) CreateOrder(ctx context.Context, order Order, payload []byte) error {
	tx, err := s.pool.Begin(ctx)
	if err != nil {
		return fmt.Errorf("begin order transaction: %w", err)
	}
	defer tx.Rollback(ctx)

	if _, err := tx.Exec(ctx,
		`INSERT INTO orders (id, customer_id, status) VALUES ($1, $2, $3)`,
		order.ID, order.CustomerID, order.Status,
	); err != nil {
		return fmt.Errorf("insert order: %w", err)
	}

	if _, err := tx.Exec(ctx,
		`INSERT INTO outbox (event_type, payload) VALUES ('order.created', $1)`,
		payload,
	); err != nil {
		return fmt.Errorf("insert outbox event: %w", err)
	}

	if err := tx.Commit(ctx); err != nil {
		return fmt.Errorf("commit order transaction: %w", err)
	}
	return nil
}
Deux identifiants, deux métiers
L’INSERT ne nomme pas event_id, le DEFAULT s’en charge. Ces deux identifiants ne font pas le même travail, et c’est voulu.
id ordonne et réserve les lignes à l’intérieur de la table : le ORDER BY id, l’index partiel, le lease qu’on verra plus bas. Une séquence est l’outil parfait pour ça. event_id est le seul des deux qui quitte le processus (gen_random_uuid() est natif depuis Postgres 13, aucune extension à installer).
Publier l’id fonctionne, jusqu’au jour où il ne fonctionne plus et ce jour-là, il échoue en silence :
- une séquence redémarre. Après une restauration, une remise à plat de la table, un redéploiement sur base neuve, les nouveaux
idretombent dans une plage que l’inbox du consommateur connaît encore. Elle écarte alors des messages légitimes en croyant dédupliquer ; - une séquence n’est unique que dans sa table. Deux producteurs sur le même broker émettent chacun leur
id = 1.
Drainer les messages à envoyer
La solution naive, notamment documenté par Oskar Dudycz, est une simple sélection :
SELECT id, payload FROM outbox
WHERE published_at IS NULL
ORDER BY id LIMIT $1
FOR UPDATE SKIP LOCKED;
Gérer des jobs asynchrones avec Postgres détaille déjà FOR UPDATE SKIP LOCKED, qui laisse plusieurs workers picorer la table au prix de l’ordre entre eux.
En revanche, cette approche force l’usage de transaction. Cela laisse ouverte une transaction le temps du batch (LIMIT $1) à publier sur le broker de message ; ce qui peut être problématique si le broker est lent ou si le batch est très gros.
Une astuce consiste à passer par un mécanisme de lease en introduisant une colonne claimed_at marquant la date de prise de possession de la ligne par le worker :
UPDATE outbox SET claimed_at = now()
WHERE id IN (
    SELECT id
    FROM outbox
    WHERE published_at IS NULL AND claimed_at IS NULL
    ORDER BY id
    LIMIT $2
    FOR UPDATE SKIP LOCKED
)
RETURNING id, event_id, event_type, payload
Une variante plus robuste regarderait uniquement les lease non pris (null) ou dans un passé proche afin de gérer les cas où un worker aurait redémarré avant de publier le message réclamer pour envoi.
published_at IS NULL AND (claimed_at IS NULL OR claimed_at < now() - make_interval(secs => $1))
Par conséquent, la table à créer ressemblera donc à cela:
CREATE TABLE IF NOT EXISTS outbox (
    id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    event_id UUID NOT NULL DEFAULT gen_random_uuid(),
    event_type TEXT NOT NULL,
    payload JSONB NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    claimed_at TIMESTAMPTZ,
    published_at TIMESTAMPTZ
);

CREATE UNIQUE INDEX IF NOT EXISTS outbox_event_id_idx ON outbox (event_id);
CREATE INDEX IF NOT EXISTS outbox_pending_idx ON outbox (id) WHERE published_at IS NULL;
Le relay qu’on réveille, plutôt qu’on interroge en boucle
Le passage dont je suis le plus content, et le seul extrait de cette série directement inspiré du code de production : le relay n’interroge pas la table à intervalle fixe, il attend sur une channel Go réveillée à chaque insertion d’une ligne outbox.
// signal is the wake channel shared between the worker (receive-only) and whatever
// enqueues intents (send-only) — the channel itself decouples the two, no shared interface.
signal := make(chan struct{}, 1)
Le buffer à 1 fait tout le travail. Si dix transactions insèrent chacune une ligne pendant que le worker est occupé, elles ne poussent qu’un seul réveil en attente.
Le relay se réveille une fois, relit la table, traite tout ce qui s’y trouve.
L’envoi côté producteur reste non bloquant, sinon un worker occupé bloquerait le service au moment d’insérer :
// Notify wakes the relay without blocking: the buffer already holds a pending wake-up if the
// relay hasn't drained it yet, so a redundant signal is simply dropped, never queued.
func (r *Relay) Notify() {
	select {
	case r.signal <- struct{}{}:
	default:
	}
}
Reste que la channel ne vit que dans le processus courant : un redémarrage la vide, et une ligne insérée par un autre biais (migration, script, rejeu manuel) ne déclenche aucun signal.
Sans ticker de secours relançant le relay indépendamment de tout signal, une ligne oubliée peut rester published_at IS NULL indéfiniment.
La channel réduit la latence perçue quand le ticker est ce qui rend le mécanisme fiable.
// Run drains on every wake-up and on every tick, until ctx is canceled. The ticker is the
// safety net: it fires on schedule whether any signal has ever reached this replica.
func (r *Relay) Run(ctx context.Context) error {
	ticker := time.NewTicker(r.interval)
	defer ticker.Stop()

	for {
		select {
		case <-ctx.Done():
			return ctx.Err()
		case <-r.signal:
			if _, err := r.drain(ctx); err != nil {
				return fmt.Errorf("drain outbox after signal: %w", err)
			}
		case <-ticker.C:
			if _, err := r.drain(ctx); err != nil {
				return fmt.Errorf("drain outbox after tick: %w", err)
			}
		}
	}
}
Le publisher confirm autorise l’UPDATE, pas l’envoi
Sans publisher confirms, publier sur RabbitMQ reste du fire-and-forget : l’appel réseau part, rien ne dit que le broker a accepté le message. Avec eux, le broker n’acquitte qu’une fois le message accepté par toutes les queues concernées, ce qui implique la persistance sur disque pour un message persistant en queue durable. Marquer published_at avant cet accusé de réception reproduirait le dual write à l’intérieur du relay lui-même.
// Publish sends the event with its event id as the RabbitMQ MessageId — the same id the
// shipping service will later use as its inbox deduplication key — and blocks until the
// broker confirms that specific delivery, positively or negatively. The row's sequence id
// stays behind: it restarts on a restore and means nothing outside this table.
//
// The confirmation is tied to this call's own DeliveryTag rather than read off a shared
// channel: a shared channel would let a confirmation abandoned by one Publish (its ctx
// cancelled while waiting) be picked up by the next one, marking the wrong row published.
func (p *RabbitPublisher) Publish(ctx context.Context, event Event) error {
	confirmation, err := p.channel.PublishWithDeferredConfirmWithContext(ctx, p.exchange, event.EventType,
		false, false, amqp.Publishing{
			MessageId:   event.EventID,
			Type:        event.EventType,
			ContentType: "application/json",
			Body: event.Payload,
		})
	if err != nil {
		return fmt.Errorf("publish event %d to rabbitmq: %w", event.ID, err)
	}

	ack, err := confirmation.WaitContext(ctx)
	if err != nil {
		return fmt.Errorf("wait for publisher confirm on event %d: %w", event.ID, err)
	}
	if !ack {
		return fmt.Errorf("broker nacked event %d", event.ID)
	}
	return nil
}
Ce que fait l’outbox, ce qu’elle ne fait pas
L’outbox garantit qu’un message finira par partir, jamais qu’il ne partira qu’une fois. Un crash du relay entre publication et marquage, un redémarrage : chaque cas peut produire un doublon, prix payé délibérément pour ne jamais en perdre.
La ligne outbox porte déjà la clé pour l’absorber côté consommateur : son event_id.
🧩 Variante avancée : aggregate_type et aggregate_id
Beaucoup d’implémentations ajoutent deux colonnes qui nomment l’entité modifiée, order et 4711. Tant que le relay
traite le payload comme une boîte noire, elles font doublon avec lui. Elles se justifient quand le relay doit
exploiter cette identité sans parser le JSON :
- ordonner par agrégat : plusieurs relays en
SKIP LOCKEDperdent l’ordre global,aggregate_idpermet de le garantir au moins pour une même commande ; - partitionner : c’est la clé naturelle d’un message Kafka, et le connecteur Debezium Outbox Event Router attend précisément ces colonnes ;
- filtrer ou rejouer l’outbox d’une entité donnée avec un index classique.
Sans l’un de ces besoins, deux colonnes de moins.
Si ce besoin se fait ressentir, voici le type de structure permettant de l’implémenter :
CREATE TABLE IF NOT EXISTS outbox (
    id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    event_id UUID NOT NULL DEFAULT gen_random_uuid(),
    aggregate_type TEXT NOT NULL,
    aggregate_id TEXT NOT NULL,
    event_type TEXT NOT NULL,
    payload JSONB NOT NULL,
    created_at TIMESTAMPTZ NOT NULL DEFAULT now(),
    claimed_at TIMESTAMPTZ,
    published_at TIMESTAMPTZ
);
L’insertion renseigne l’agrégat explicitement, le lease le renvoie avec le reste :
INSERT INTO outbox (aggregate_type, aggregate_id, event_type, payload) VALUES ('order', $1, 'order.created', $2)$1 = order.ID / $2 = payload
On n’oubliera pas de renvoyer les deux colonnes manquantes :
UPDATE outbox SET claimed_at = now()
WHERE id IN (
    SELECT id
    FROM outbox
    WHERE published_at IS NULL AND claimed_at IS NULL
    ORDER BY id
    LIMIT $2
    FOR UPDATE SKIP LOCKED
)
RETURNING id, event_id, aggregate_type, aggregate_id, event_type, payload
Côté publication, RabbitMQ n’a pas de clé de partition comme Kafka : l’agrégat voyage en headers, que le consommateur peut logger ou filtrer.
amqp.Publishing{
	MessageId:   event.EventID,
	Type:        event.EventType,
	ContentType: "application/json",
	Headers: amqp.Table{
		"x-aggregate-type": event.AggregateType,
		"x-aggregate-id":   event.AggregateID,
	},
	Body: event.Payload,
}
📚 Ressources
- Oskar Dudycz — How Postgres sequences issues can impact your messaging guarantees
- Sadeq Dousti — PostgreSQL + Outbox Pattern Revamped, Part 1
- PostgreSQL — README.HOT (arbre source)
- PostgreSQL docs — CREATE INDEX
- Gunnar Morling — Revisiting the Outbox Pattern
- RabbitMQ docs — Consumer Acknowledgements and Publisher Confirms
- The Outbox Pattern Explained (Complete Guide)
- Modèle de boîte d’envoi : Correction des échecs d’événements dans une architecture événementielle
- The Outbox Pattern is seriously underrated…