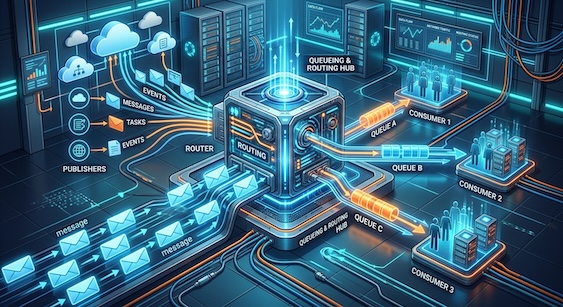
Chez un client, chaque service consommateur branché sur l’exchange RabbitMQ recevait la totalité des messages publiés.
Chaque queue bindait avec le wildcard catch-all (#), celui qui capte tout ce qui transite sur l’exchange. Un service qui ne traitait qu’un type d’événement sur dix désérialisait quand même les neuf autres, pour les jeter aussitôt. Dans certains cas, ce déchet atteignait 90 % du trafic reçu.
Ça a fonctionné longtemps, sans que personne y trouve à redire. Puis un pic d’un million de messages d’un seul type a mis plusieurs heures de retard sur des traitements qui n’avaient pourtant rien à voir avec lui.
🕰️ Un catch-all qui passait inaperçu, jusqu’à ce que le volume change de nature
Ce pic n’est qu’un symptôme. Ce qu’il révèle :
la plateforme publie désormais couramment plusieurs dizaines de millions de messages par jour, en régime permanence 👉 lire tous les messages / évènements tout le temps devient problématique.
Le binding # sur chaque queue n’a jamais été un choix dangereux en soi.
Tant que les volumes restaient modestes, filtrer après désérialisation coûtait quelques cycles CPU négligeables, invisibles dans les métriques. Chaque service savait reconnaître ce qui ne le concernait pas et passait à autre chose sans que personne y prête attention.
La croissance normale de l’usage de la plateforme a changé la donne.
À plusieurs dizaines de millions de messages par jour, faire transiter puis rejeter 90 % d’un flux de cette taille n’est plus un détail d’implémentation indolore pour nos utilisateurs.
Jusqu’à présent, les volumes étaient encore raisonnables (~100k msg/sec en continue), mais aujourd’hui avec un million de messages par seconde, le coût de cette pratique est devenu visible.
📊 Le pic qui a rendu le coût visible
Le déclencheur a été concret. Un type d’événement précis a généré plus d’un million de messages sur une courte fenêtre.
Ca a déclenché, ce qu’on appelle un spike.
Le vrai coût est l’ordre de traitement que ce travail perdu impose.
Une queue RabbitMQ traite ses messages en séquence. Tant que le million de messages indésirables n’est pas épuisé, les messages métiers arrivés attendent leur tour, même s’ils n’ont aucun rapport avec le pic en cours.
Nous aurions pu utiliser les niveaux de priorité pour limiter le nombre de messages indésirables à traiter.
Cela aurait été une solution pour notre service, mais il aurait masquer d’autres problématiques pour d’autres services de la plateforme qui gèrent déjà différents niveaux de priorités.
Le véritable problème auquel on se confronté est clairement expliqué par RabbitMQ:
C’est le head-of-line blocking : un flot massivement redondant qui bloque la file pour tout ce qui le suit, quelle que soit sa priorité réelle.
D’ailleurs, la documentation RabbitMQ l’explique bien :
Prioriser des messages à l’intérieur d’une queue ne suffit pas, il faut utiliser plusieurs queues : une queue, un type de trafic et pas une queue qui essaie d’arbitrer entre plusieurs types à la fois.
🤝 La routing key devient le contrat entre producteur et consommateurs
L’idée retenue déplace le filtrage du code applicatif vers le broker.
Le producteur s’est mis à tagger chaque message publié avec une routing key structurée, qui encode le type d’entité concerné et, pour certains flux, une variante. Il ne publie plus à plat sur l’exchange en laissant chaque service se débrouiller après coup dans son propre code.
Côté consommation, chaque queue ne bind plus que les routing keys qu’elle traite réellement, au lieu du # universel.
Un exchange topic RabbitMQ sait faire ce tri nativement :
*capture exactement un segment de la clé,#en capture zéro ou plusieurs.
La sémantique complète est posée dans la documentation des exchanges. Rien n’empêchait de s’en servir plus finement dès le départ.
Le mécanisme de routage existait depuis toujours, personne n’en avait eu besoin tant que le volume restait raisonnable.
Le changement de posture tient en une phrase : un message qui ne concerne pas un service ne devrait jamais atterrir dans sa queue. Le filtrage n’est plus une étape du code de chaque consommateur, il devient une propriété du routage, vérifiée par le broker avant même que le service n’ait à ouvrir le message.
Désormais si un service consomme tous les messages d’un topic, c’est sa responsabilité, car rien ne lui oblige.
Il peut maintenant choisir sur quels évènements du topic, il souhaite s’abonner.
🎯 Multiplier les bindings ne coûte rien, l’ordre de déploiement si
Une objection naturelle se pose :
passer d’un binding par queue à plusieurs dizaines n’alourdit-il pas le broker ?
Le routage topic de RabbitMQ est implémenté comme une structure de trie pensée précisément pour ce cas : un billet du blog RabbitMQ montre que le temps de routage reste stable même avec un grand nombre de bindings. Une mesure indépendante confirme l’ordre de grandeur : jusqu’à 10 000 bindings par queue sans dégradation de performance mesurable.
Le point d’attention réel se situe dans la fenêtre de propagation quand on crée un grand nombre de bindings d’un coup sur un cluster, pas dans le coût du routage lui-même.
👉 La complexité du routage n’est donc pas ce qu’il faut craindre.
La précaution qui compte vraiment porte sur la séquence de déploiement.
RabbitMQ ne route un message que s’il correspond à un binding existant au moment de la publication.
⚠️ Sans binding correspondant, le message est perdu silencieusement (sauf à avoir configuré un exchange alternatif comme filet de sécurité).
🚧 Méthode de déploiement
Le producteur doit d’abord poser les routing keys sur tous ses messages, pendant que les consommateurs restent encore en catch-all, et seulement ensuite chaque service peut remplacer son # par les clés qui le concernaient réellement.
Inverser ces deux étapes, ne serait-ce que pour un seul service pressé de nettoyer son binding, suffit à le couper de tout message, en silence.
📅 Une semaine après, une consommation revenue à une taille raisonnable
Le changement a été suivi une semaine après sa mise en place. Les vagues de centaines de milliers de messages qui submergeaient périodiquement les services consommateurs ont disparu. La consommation moyenne par queue est tombée autour de 50 messages par seconde, loin des volumes qui transitaient auparavant pour être ignorés.
Rien de spectaculaire dans le mécanisme :
une routing key mieux structurée et des bindings plus précis, sans nouveau composant ni nouvelle infrastructure.
L’effet, lui, se voit directement dans les métriques de queue depth et dans la disparition des retards en cascade sur les traitements prioritaires.
🧠 Ce que j’en retiens comme expérience
Sur une plateforme où des queues bindent encore en # sur un exchange topic à fort volume, ça posera problème un jour ou l’autre.
La seule inconnue est le volume qui le rendra visible.
Concevoir la routing key comme un contrat explicite entre producteur et consommateurs, plutôt que comme un détail d’implémentation, coûte peu à écrire et évite de découvrir le head-of-line blocking en production, un million de messages à la fois.
Un exchange alternatif en filet de sécurité vaut aussi la peine, surtout pendant la fenêtre de transition où producteur et consommateurs ne sont pas encore alignés sur le même schéma de clés.
💡 Tout le code est sur github.