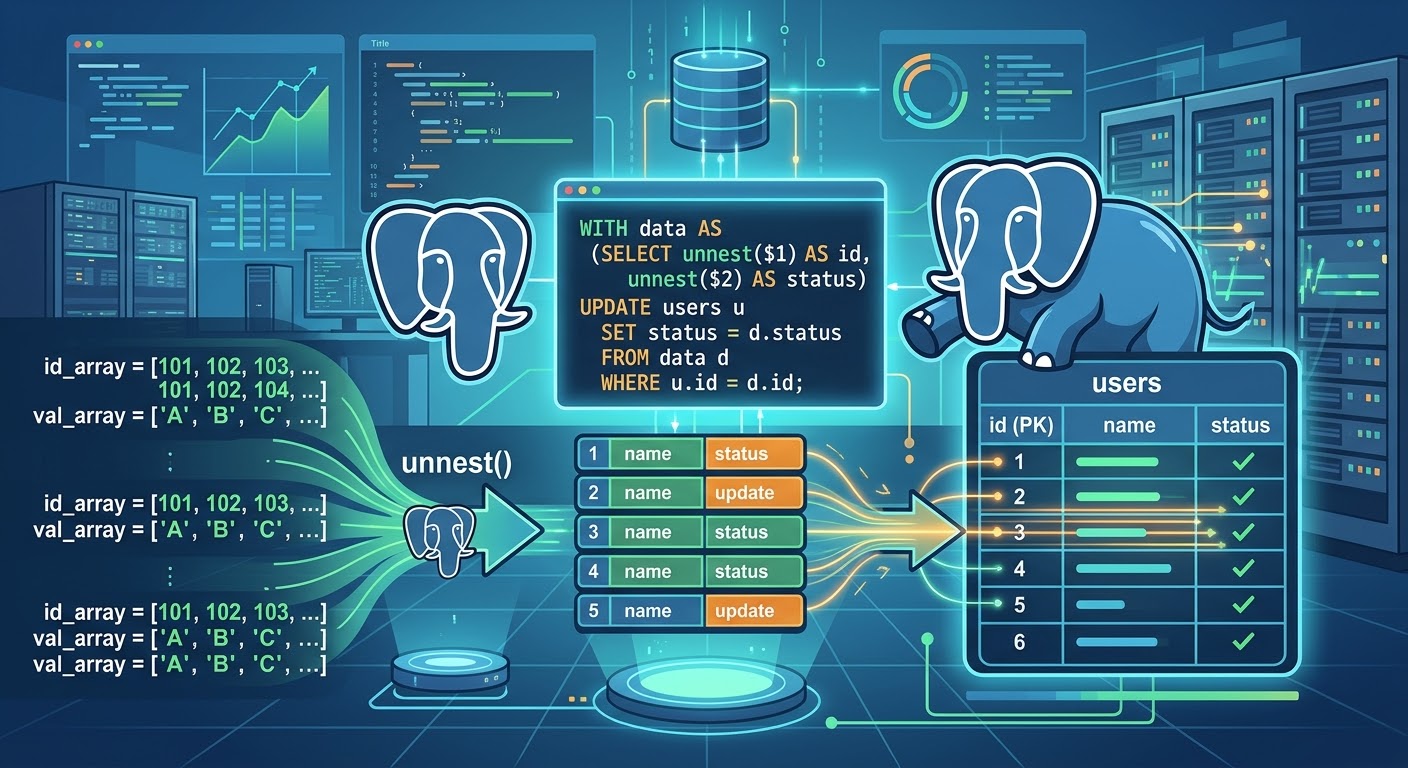
Un job nocturne réécrit des statistiques pour toutes les lignes d’un tenant avec une seule instruction UPDATE … FROM (VALUES …). Le service impose un statement_timeout de 10 s, et l’instruction est annulée avec l’erreur 57014.
Cet article décrit le coût d’un VALUES de 150 000 lignes pour le serveur, réécrit la requête avec unnest, puis compare les deux.
Avant : une ligne de VALUES par capteur, assemblée dans un texte de 27 Mo.
Après : huit tableaux passés à unnest dans la même instruction.
Le timeout de 10 s couvre toute l’instruction
Le service applique un statement_timeout de 10 s à toutes ses requêtes.
Le délai court de l’arrivée de la commande sur le serveur jusqu’à sa fin.
En protocole étendu, il démarre à la réception de Parse, Bind, Execute ou Describe[1]. Une instruction qui le dépasse échoue avec le SQLSTATE 57014 et le message canceling statement due to statement timeout.
Le job nocturne recalcule des statistiques par capteur pour un tenant.
Un service de calcul externe fournit les valeurs :
- un nombre de relevés,
- une moyenne,
- un nombre d’heures manquantes pour la température,
- l’humidité et la puissance.
Un capteur sur trois est absent de la réponse et reçoit des NULL ; un autre sur trois a des statistiques à 0.
CREATE TABLE sensors (
    id                        text PRIMARY KEY,
    tenant_code               text NOT NULL,
    -- … colonnes descriptives (label, model, firmware_version, location, metadata, dates)
    reading_count             integer,
    avg_temperature           numeric,
    temperature_missing_hours integer,
    avg_humidity              numeric,
    humidity_missing_hours    integer,
    avg_power                 numeric,
    power_missing_hours       integer,
    stats_refreshed_at        timestamptz
) WITH (autovacuum_enabled = false);
CREATE INDEX sensors_tenant_code_idx ON sensors (tenant_code);
Le jeu de données contient 150 000 capteurs pour le tenant ACME et 20 000 capteurs pour chacun des tenants GLOBEX, INITECH et UMBRELLA, soit 210 000 lignes.
La table complète, avec ses colonnes descriptives, pèse 53 Mo.
L’autovacuum est désactivé sur cette table uniquement pour rendre lisibles les compteurs de tuples morts.
Détails de l’environnement technique
Les mesures tournent dans un conteneur postgres:18 (PostgreSQL 18.6, aarch64) limité à 2 vCPU et 2 Go, sauf mention contraire. Il s’exécute dans une VM Docker Desktop de 4 CPU et 7,75 Gio, sur un hôte Apple M5 Max. shared_buffers (128 Mo) et work_mem (4 Mo) gardent leurs valeurs par défaut. statement_timeout vaut 10 s via PGOPTIONS. Un VACUUM FULL puis un CHECKPOINT précèdent chaque mesure.
Les scripts de ces mesures sont dans le dépôt d’exemple[11].
Le pic de mémoire résidente (VmHWM) vient du noyau Linux, qui l’expose dans /proc/<pid>/status. Il couvre toute la durée de vie du processus serveur : chaque mesure utilise donc une connexion neuve. psql doit tourner dans le conteneur du serveur : sans cela, /proc ne montre pas le processus.
SELECT pg_backend_pid() AS pid \gset
\setenv PID :pid
\! grep VmHWM /proc/$PID/status
\i requete.sql
\! grep VmHWM /proc/$PID/status
La requête initial : une CTE générée par un ORM
L’ORM bun construit la requête avec Bulk(). Elle prend la forme d’une CTE _data qui contient une ligne de VALUES par capteur, chaque valeur étant castée[2]. La jointure sur sensors suit la syntaxe UPDATE … FROM décrite dans “Une requête, plusieurs écritures dans PostgreSQL”.
WITH "_data" ("id", "reading_count", "avg_temperature", "temperature_missing_hours", "avg_humidity",
              "humidity_missing_hours", "avg_power", "power_missing_hours", "stats_refreshed_at") AS (VALUES
  ('0000ae6c-…'::text, 0::integer, 0::numeric, 0::integer, 0::numeric, 0::integer, 0::numeric, 0::integer,
   '2026-10-23 02:00:00+00'::timestamptz),
  ('00039fda-…'::text, NULL::integer, NULL::numeric, NULL::integer, NULL::numeric, NULL::integer, NULL::numeric,
   NULL::integer, '2026-10-23 02:00:00+00'::timestamptz), …)
UPDATE "sensors" AS "s" SET "reading_count" = _data."reading_count", … , "stats_refreshed_at" = _data."stats_refreshed_at"
FROM _data WHERE ("s"."id" = _data."id") AND (s.tenant_code = 'ACME');
Pour 150 000 lignes, le texte envoyé au serveur pèse 27 350 680 octets, soit 27 Mo.
Côté Go, la construction tient en un appel :
// Avant : une ligne de VALUES par capteur, assemblée et formatée côté client.
stmt := db.NewUpdate().
    Model(&stats).
    Column("reading_count", "avg_temperature", /* … 6 autres colonnes */).
    Where("s.id = _data.id").
    Bulk()
_, err := db.ExecContext(ctx, stmt)
Un gros VALUES tue le processus serveur ou dépasse les 10 s
Pour reproduire en local, on a dû élaborer plusieurs banc de test.
🚧 C’est souvent le plus compliqué : reproduire le comportement d’un environement.
C’est souvent celui de production mais pas que. En effet, cela nous est déjà arrivé de détecter un comportement en staging avant d’atteindre la production 😉
Le tableau suivant reprend les mesures de l’instruction VALUES sur le tenant entier, en une seule requête :
| Cas | Ressources | Résultat brut |
|---|---|---|
| 150 000 lignes | 2 vCPU, 2 Go | 2495, 1207, 1209 ms puis 1340, 1312, 1277 ms — UPDATE 150000 |
| 600 000 lignes | 2 vCPU, 2 Go | server closed the connection unexpectedly ; log : client backend (PID 386) was terminated by signal 9: Killed (OOM, reproduit deux fois) |
| 600 000 lignes | 2 vCPU, 6 Go | 7761 ms, puis 5539 ms |
| 600 000 lignes | 0,5 vCPU, 6 Go | ERROR: 57014: canceling statement due to statement timeout après 10 867,741 ms |
À 150 000 lignes, le VALUES passe sous la limite sur la machine de test : environ 1,3 s, pour six exécutions entre 1,2 et 2,5 s.
Le timeout n’a pas été reproduit à ce volume car cela dépend des ressources.
Avec 2 Go de mémoire, le processus serveur est tué (SIGKILL, kill -9) à 600 000 lignes mais sous 6 Go et 0,5 vCPU, la requête dépasse 10 s comme observé sur l’environnement de test.
ℹ️ La limite de 0,5 vCPU simule une instance modeste, dont la taille réelle est inconnue.
Les durées totales de 150 000 à 600 000 lignes sont trop bruitées pour conclure plus.
L’instruction échoue :
- soit par manque de mémoire (processus tué avec 2 Go)
- soit par manque de temps (
57014avec 0,5 vCPU).
Ce que l’équipe a observé sur son environnement
L’équipe à l’origine du job a mesuré le même UPDATE … FROM (VALUES …) sur ses propres machines. Ces mesures viennent d’un autre environnement que celles du tableau ci-dessus et ne sont pas comparables.
Sur l’environnement de test, le job échouait chaque nuit avec 57014 pour un tenant d’environ 100 000 lignes. Sur une copie locale de la base de développement (conteneur PostgreSQL 18.1, 150 000 lignes synthétiques, statement_timeout de 10 s), l’instruction a duré 16,4 s avant d’être annulée, puis le processus serveur a été tué par manque de mémoire.
À 150 000 lignes, les mesures de cet article passent en environ 1,3 s sur la machine de test (2 vCPU, 2 Go). La cause de l’écart entre 16,4 s et 1,3 s n’est pas vérifiée. Les deux environnements diffèrent par la machine, la configuration du conteneur PostgreSQL et le jeu de données : lignes synthétiques de l’équipe, schéma anonymisé ici.
Réécrire avec unnest : un tableau par colonne
La réécriture change la forme de la requête, pas les lignes écrites.
Chaque colonne devient un tableau :
- un paramètre pour tous les identifiants,
- un autre pour toutes les valeurs d’une colonne.
UPDATE sensors AS s
SET reading_count = v.reading_count, avg_temperature = v.avg_temperature,
    temperature_missing_hours = v.temperature_missing_hours, avg_humidity = v.avg_humidity,
    humidity_missing_hours = v.humidity_missing_hours, avg_power = v.avg_power,
    power_missing_hours = v.power_missing_hours, stats_refreshed_at = $9
FROM unnest($1::text[], $2::int[], $3::numeric[], $4::int[], $5::numeric[], $6::int[], $7::numeric[], $8::int[])
     AS v(id, reading_count, avg_temperature, temperature_missing_hours, avg_humidity,
          humidity_missing_hours, avg_power, power_missing_hours)
WHERE s.id = v.id AND s.tenant_code = $10;
unnest accepte plusieurs tableaux seulement dans la clause FROM.
Il renvoie une colonne par tableau, complète les plus courts avec des NULL[3] et équivaut à ROWS FROM[4].
Les 3 cas limites
- NULL et zéro :
'{12, NULL, 0}'::int[]et'{21.5, NULL, 0}'::numeric[]écrivent12 | 21.5, deux NULL, puis0 | 0. NULL reste NULL et 0 reste 0. - Longueurs différentes :
unnest('{a,b,c}'::text[], '{1,2}'::int[])renvoie la lignecavecnà NULL. Un tableau d’identifiants plus long que les tableaux de valeurs écrase donc des colonnes par NULL, sans erreur. - Doublon d’identifiant : avec les valeurs 100 et 200, l’instruction répond
UPDATE 1et retient 100, mais la ligne utilisée n’est pas prévisible[5]. Un paquet ne doit contenir chaque identifiant qu’une fois.
Exemple : trois capteurs, mais seulement deux valeurs par colonne.
UPDATE sensors s
SET reading_count = d.reading_count, avg_temperature = d.avg_temperature
FROM unnest('{s1,s2,s3}'::text[], '{11,21}'::int[], '{20.5,21.5}'::numeric[])
     AS d(id, reading_count, avg_temperature)
WHERE s.id = d.id;L’instruction répond UPDATE 3, sans erreur. Le capteur s3 perd ses valeurs :
| id | reading_count | avg_temperature | ||
|---|---|---|---|---|
| avant | après | avant | après | |
| s1 | 10 | 11 | 20.0 | 20.5 |
| s2 | 20 | 21 | 21.0 | 21.5 |
| s3 | 30 | NULL | 22.0 | NULL |
Pour 150 000 lignes, la requête et ses valeurs liées pèsent 9 350 693 octets, contre 27 350 680 octets pour le texte du VALUES.
Côté Go, la réécriture change l’appel :
// Après : les tableaux passent en paramètres liés (pgx).
// Dix paramètres, quel que soit le nombre de lignes.
_, err = conn.Exec(ctx, updateSQL,
    pgtype.FlatArray[string](ids),
    pgtype.FlatArray[int32](counts),
    pgtype.FlatArray[pgtype.Numeric](avgTemps),
    pgtype.FlatArray[int32](missingTemps),
    pgtype.FlatArray[pgtype.Numeric](avgHums),
    pgtype.FlatArray[int32](missingHums),
    pgtype.FlatArray[pgtype.Numeric](avgPows),
    pgtype.FlatArray[int32](missingPows),
    statsRefreshedAt, tenant)
VALUES contre unnest : planification et mémoire
Les requêtes VALUES et unnest écrivent les mêmes lignes.
La différence porte sur la planification et la mémoire, pas sur le temps d’exécution du plan.
L’option MEMORY d’EXPLAIN affiche la mémoire consommée par la planification[6]. Pour un paquet de 2 000 lignes, c’est-à-dire un UPDATE qui ne cible que 2 000 des 150 000 capteurs du tenant, elle atteint 6 219 kB avec VALUES contre 186 kB avec unnest.
L’analyse du plan, Hash Join contre Nested Loop, est traitée dans un prochain article.
La mémoire de planification suit la taille de la liste. Premier paquet de chaque taille :
| Taille | Méthode | Jointure | Mémoire | Planification | Exécution |
|---|---|---|---|---|---|
| 2 000 | VALUES | Hash Join | 6 219 kB | 2,355 ms | 30,0 ms |
| 2 000 | unnest | Nested Loop | 186 kB | 0,279 ms | 11,1 ms |
| 20 000 | VALUES | Hash Join | 62 051 kB | 17,1 ms | 109,3 ms |
| 20 000 | unnest | Hash Join | 1 431 kB | 0,490 ms | 115,7 ms |
| 150 000 | VALUES | Hash Join | 465 455 kB | 139,1 ms | 754,2 ms |
| 150 000 | unnest | Hash Join | 10 489 kB | 1,369 ms | 763,2 ms |
Avec VALUES, le planificateur consomme environ 3,1 kB par ligne, de façon linéaire : 465 455 kB à 150 000 lignes. Avec unnest, la requête ne transmet qu’une constante tableau par colonne, et la mémoire de planification reste à 10 489 kB au même volume. À 150 000 lignes, le temps d’exécution est comparable (754,2 ms contre 763,2 ms). La différence porte sur la planification (139,1 ms contre 1,369 ms) et sur la mémoire.
Le tableau suivant reprend les mesures d’unnest sur le tenant entier, en une seule requête.
| Cas | Ressources | Résultat brut |
|---|---|---|
| unnest bind, 150 000 lignes | 2 vCPU, 2 Go | 782, 781, 781 ms |
| unnest bind, 600 000 lignes | 0,5 vCPU, 6 Go | 8391,923 ms (84 % du budget) ; 9 806 et 9 890 ms (98 à 99 %) lors de deux reproductions |
Le pic de mémoire résidente du processus serveur (VmHWM) atteint, à 150 000 lignes, 1 239 644 kB avec VALUES et 179 560 kB avec unnest. Avec VALUES, il monte à 1 755 468 kB à 300 000 lignes et à 4 269 264 kB à 600 000 lignes (limite de 6 Go).
VmHWM) du processus serveur pour une requête sur le tenant entier. Les mesures à 150 000 et 300 000 lignes tournent sous une limite de 2 Go, celle à 600 000 lignes sous 6 Go : avec 2 Go, le processus est tué.Pourquoi EXPLAIN affiche moins que le client
EXPLAIN donne une durée plus courte que celle vue par le client.
À 150 000 lignes, le client mesure 1,21 à 1,34 s pour cinq des six exécutions du VALUES, contre 0,89 s dans EXPLAIN.
L’écart d’environ 0,4 s est déduit, non profilé : il correspondrait à l’analyse du texte, que le timeout compte, et à son transport, que le délai ne compte pas (« from the time a command arrives at the server »).
Pour unnest, l’écart est négligeable (0,78 s contre 0,765 s).
La documentation d’EXPLAIN ne précise pas si « Planning Time » inclut l’analyse.
Un billet de Tiger Data attribue aussi l’essentiel du gain d’unnest à la planification[7].
ℹ️ Il porte sur des
INSERTet n’indique pas la version de PostgreSQL.
La limite de 65 535 paramètres liés
Le message Bind du protocole PostgreSQL code le nombre de paramètres sur 16 bits, soit 65 535 au maximum[8][9][10]. Avec neuf paramètres par ligne, un VALUES échoue à 7 282 lignes (65 538 paramètres), avec l’erreur number of parameters must be between 0 and 65535 (test sur un SELECT count(*) FROM (VALUES …)). unnest avec N tableaux n’utilise que N paramètres, quel que soit le nombre de lignes.
bun n’est pas concerné
bun n’utilise pas de paramètres liés. Il écrit les valeurs, échappées, dans le texte SQL côté client (db.format, puis ExecContext)[2].
Ses huit tableaux deviendraient donc huit littéraux.
À 150 000 lignes, la variante « bind » (paramètres liés, comme pgx) dure 781,4 ms et la variante « inline » (littéraux, comme bun) 782,5 ms.
Le gain vient de la forme de la requête, pas du protocole.
Conclusion
VALUES et unnest écrivent les mêmes lignes avec un temps d’exécution comparable (754 ms contre 763 ms à 150 000 lignes).
La différence porte sur la planification :
- 465 455 kB et 139,1 ms pour
VALUES, - 10 489 kB et 1,369 ms pour
unnest.
Selon les ressources, ce coût fait tuer le processus serveur ou dépasser les 10 s.
Ressources
- PostgreSQL : Client Connection Defaults
- bun v1.3.0 :
query_update.go(UpdateQuery.Bulk()construit la CTE_data),query_values.go(génération duVALUESet des casts) etdb.go(db.format,ExecContext) - PostgreSQL : Array Functions and Operators
- PostgreSQL : Table Expressions
- PostgreSQL : UPDATE
- PostgreSQL : EXPLAIN
- Tiger Data : Boosting Postgres INSERT Performance
- PostgreSQL : Message Formats
- PostgreSQL, branche
REL_18_STABLE: libpqfe-exec.cetlibpq-fe.h, serveurpostgres.c - pgx :
pgconn/pgconn.go - Dépôt d’exemple : postgres-write-in-batches