Dans l’article précédent, l’outbox Postgres résout la perte de message : une transaction, une table, un relay qui publie. Elle ne promet que de l’at-least-once.
Le relay peut crasher entre la publication vers RabbitMQ et la validation sur postgres.
Conséquence 👉 au redémarrage, on délivre à nouveau toute livraison non acquittée.
Le consommateur reçoit donc des doublons.
Ce n’est pas un incident, c’est le comportement attendu du système, et la moitié qui manque à la chaîne : consommer sans retraiter.
RabbitMQ recommande l’idempotence, pas la déduplication
Le guide de fiabilité de RabbitMQ recommande de rendre le consommateur idempotent plutôt que de dédupliquer explicitement.
Un
UPSERTpar clé métier n’a besoin d’aucune inbox : le traiter deux fois donne le même état.
L’inbox n’est donc pas le réflexe par défaut, elle sert quand l’effet ne se rejoue pas :
- un email parti,
- un compteur incrémenté plutôt que fixé.
📝 Remarque
Chez mon client, nous l’avons implémenté pour une tout autre raison.
On ne tolérait pas des traitements trop longs sur des messages (> 20min).
Il nous a donc fallu trouver un système pour stocker temporairement les messages en attente de traitement et l’inbox nous a semblé être une solution.
La clé qui ne marche pas, et celle qui marche
Le premier réflexe est d’utiliser le deliveryTag que RabbitMQ associe à chaque livraison.
Mauvaise idée 👉 ce tag est scoped per channel, un entier croissant qui identifie une livraison, pas un message. Le même message, redélivré après une reconnexion, arrive avec un tag différent. Aucune déduplication possible.
La clé correcte est un identifiant stable produit par l’émetteur, transporté dans le message. Ici la boucle avec l’article précédent se referme : c’est l’event_id de la ligne outbox Postgres, généré à l’insertion, avant toute publication, donc stable à travers toutes les redélivrances.
L’inbox appartient au service qui consomme, et cet identifiant lui suffit comme clé.
// Document records that a message has been (or is being) processed, so a redelivery of the
// same message can be recognised and dropped instead of reprocessed. The collection belongs to
// this service alone, so the message id is the whole key.
type Document struct {
	MessageID   string     `bson:"messageId"`
	ProcessedAt *time.Time `bson:"processedAt,omitempty"`
}

// UniqueIndexModel enforces at most one document per messageId: the database arbitrates
// concurrent deliveries instead of the application coding that race itself.
func UniqueIndexModel() mongo.IndexModel {
	return mongo.IndexModel{
		Keys:    bson.D{{Key: "messageId", Value: 1}},
		Options: options.Index().SetUnique(true),
	}
}
Insérer et traiter dans la même transaction
📘 La méthode standard
C’est l’approche que décrivent la plupart des articles sur l’inbox pattern, et celle qui offre la garantie la plus forte : soit les deux écritures passent ensemble, soit aucune.
INSERTinbox et traitement métier dans la même transaction, ack RabbitMQ seulement après le commit. Le prix à payer est la durée : la transaction Mongo reste ouverte tout le temps que dure l’effet métier, plafonnée par défaut à 60 secondes.
// HandleDelivery stamps the inbox record with the moment it was processed — the same
// transaction that runs effect is what makes that timestamp true, and it's what later lets the
// TTL index reap the record — then acks only once that transaction has actually committed. A
// duplicate or a write conflict never reach the caller as a plain error, they're resolved into
// the right acknowledgement instead.
func (c *Consumer) HandleDelivery(ctx context.Context, doc Document, ack Acker, effect BusinessEffect) error {
	now := time.Now().UTC()
	doc.ProcessedAt = &now

	session, err := c.client.StartSession()
	if err != nil {
		// Every exit from here on settles the delivery. Returning an unsettled one would leave it
		// holding a prefetch slot until the connection drops, and enough of them stall the consumer.
		if retryErr := ack.Retry(); retryErr != nil {
			return fmt.Errorf("requeue delivery after failing to start session: %w", retryErr)
		}
		return fmt.Errorf("start session: %w", err)
	}
	defer session.EndSession(ctx)

	_, txErr := session.WithTransaction(ctx, func(sc mongo.SessionContext) (interface{}, error) {
		if _, err := c.collection.InsertOne(sc, doc); err != nil {
			return nil, err
		}
		return nil, effect(sc)
	})
	if txErr != nil {
		return resolveTransactionError(txErr, ack)
	}

	return ack.Ack()
}
Cela couvre le cas passant :
un crash avant le commit déclenche un rollback complet, puis une redélivrance entrainant un retraitement propre.
En revanche, dans le cas suivant :
un crash après le commit et avant l’ack fait requeuer le message, mais l’insert suivant échoue sur la contrainte d’unicité, on ack et on jette.
On perd donc un traitement que l’inbox est censée absorber.
Dans mon usage : décorréler enregistrement et traitement
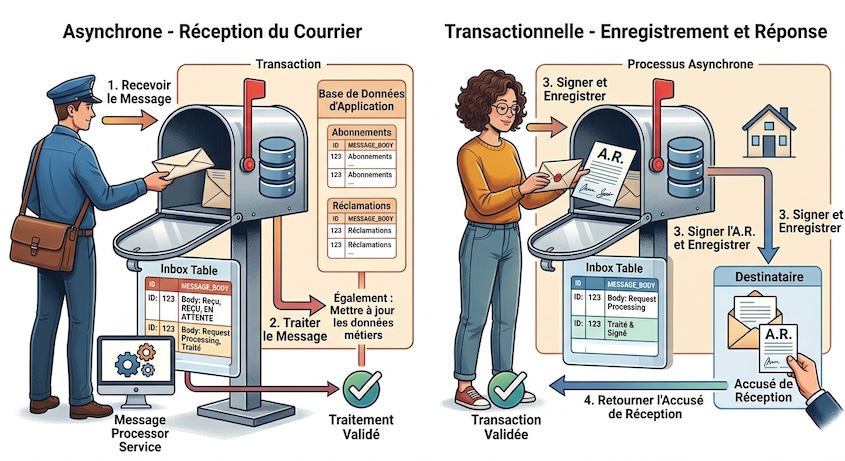
Chez mon client, je n’utilise pas la méthode canonique. Le motif est celui évoqué en ouverture : des traitements qui peuvent dépasser 20 minutes, bien au-delà des 60 secondes qu’une transaction Mongo tolère. Garder la transaction ouverte tout ce temps n’est pas une option, je sépare donc l’enregistrement du message et son traitement en deux tâches indépendantes :
- la première ne fait qu’enregistrer : elle insère le document dans l’inbox avec
processedAtànil, et acquitte RabbitMQ aussitôt ; - la seconde tourne indépendamment, va chercher les documents dont
processedAtest encorenil, exécute l’effet métier, puis pose leprocessedAtassocié à un TTL.
// RecordDelivery stores the delivery as unprocessed as soon as it arrives, then acks immediately.
//
// The message is safe in the inbox no matter how long processing eventually takes.
func (c *Consumer) RecordDelivery(ctx context.Context, doc Document, ack Acker) error {
	doc.ProcessedAt = nil

	if _, err := c.collection.InsertOne(ctx, doc); err != nil {
		if IsDuplicate(err) {
			return ack.Drop()
		}
		return ack.Retry()
	}
	return ack.Ack()
}
// ProcessPending runs on a separate goroutine, polling for documents RecordDelivery left unprocessed.
//
// Stamping processedAt here is what later lets the TTL index reap the record once its retention window elapses.
func (w *Worker) ProcessPending(ctx context.Context, effect func(ctx context.Context, doc Document) error) error {
cursor, err := w.collection.Find(ctx, bson.D{{Key: "processedAt", Value: nil}})
if err != nil {
return fmt.Errorf("find pending documents: %w", err)
}
defer cursor.Close(ctx)
for cursor.Next(ctx) {
var doc Document
if err := cursor.Decode(&doc); err != nil {
return fmt.Errorf("decode pending document: %w", err)
}
if err := effect(ctx, doc); err != nil {
continue // left unprocessed, picked up again on the next pass
}
now := time.Now().UTC()
filter := bson.D{{Key: "messageId", Value: doc.MessageID}}
update := bson.D{{Key: "$set", Value: bson.D{{Key: "processedAt", Value: now}}}}
if _, err := w.collection.UpdateOne(ctx, filter, update); err != nil {
return fmt.Errorf("mark document processed: %w", err)
}
}
return cursor.Err()
}Ce découplage a un prix : l’atomicité disparaît.
Un crash entre l’exécution de effect et la pose de processedAt laisse le document dans un état ambigu : traité, mais pas marqué comme tel même si ProcessPending le reprendra au passage suivant.
effect doit donc être idempotent, ce qui ramène à la recommandation de RabbitMQ en ouverture de cet article :
la déduplication de l’insertion ne suffit plus à elle seule, c’est l’effet lui-même qui doit supporter d’être rejoué.
En échange, aucune transaction Mongo ne reste ouverte pendant que l’effet tourne, et les deux tâches passent à l’échelle indépendamment :
ralentir le traitement n’affecte jamais le débit d’enregistrement, ni l’inverse.
Deux consommateurs, une seule course
Si deux instances traitent le même message en parallèle, l’index unique suffit à arbitrer : on délègue la décision au moteur plutôt que de la coder soi-même.
Le perdant reçoit une erreur E11000 (violation d’unicité), et la réponse correcte est simple, ack et drop, sans log ni retry.
⚠️ A ne pas confondre avec un write conflict où l’abandon transitoire d’une transaction en désaccord avec une autre sur les mêmes documents.
E11000veut dire « déjà traité, ack » ; un write conflict veut dire « réessaie »
Les deux ne se présentent pas au même moment : le doublon remonte tout de suite, alors que WithTransaction réessaie déjà les erreurs transitoires pendant deux minutes avant d’abandonner 👉 donc voir un write conflict ici signifie qu’il a survécu à ces tentatives.
const (
	duplicateKeyCode  = 11000
	writeConflictCode = 112
)

// IsDuplicate reports a duplicate key violation on the inbox's messageId index: the nominal case where this message was already processed.
// The right reaction is to ack and drop it — no error, no retry.
func IsDuplicate(err error) bool { return hasCode(err, duplicateKeyCode) }

// IsWriteConflict reports a MongoDB write conflict between transactions racing on the same
// documents — unrelated to the duplicate above, and the opposite reaction applies: the message
// should be retried rather than dropped. Reaching this branch means the conflict outlived the
// retries WithTransaction already performs on transient errors, so it is genuinely stuck.
func IsWriteConflict(err error) bool { return hasCode(err, writeConflictCode) }

func resolveTransactionError(err error, ack Acker) error {
	switch {
	case IsDuplicate(err):
		return ack.Drop()
	case IsWriteConflict(err):
		return ack.Retry()
	default:
		return ack.Retry()
	}
}
Le TTL qui n’expire jamais ce qui n’est pas traité
Le code de production, en Kotlin / Spring Data, est celui qui tourne réellement chez mon client :
// TTL: expire 14 days after processedAt (Mongo deletes when processedAt + 14d < now)
@Indexed(name = "ttl_processedAt_14d", expireAfter = "P14D")
val processedAt: Instant? = null
L’astuce tient en une ligne : un document dont processedAt vaut null n’expire jamais, parce que null n’est pas un BSON Date et que le TTL n’expire que les champs de ce type. Ce n’est pas un effet de bord, c’est un comportement documenté par Mongo, et il tombe exactement où on en a besoin, car un message reçu, mais pas encore traité, ne doit pas disparaître.
L’équivalent Go dit la même chose.
Le *time.Time laissé à nil disparaît du document grâce au omitempty, là où un time.Time en valeur zéro produirait une date de l’an 1 et expirerait aussitôt :
// DefaultRetention covers the slowest realistic redelivery path: a dead-letter queue replayed after a human investigates an incident.
// There is no canonical value for this window; two weeks is an operational choice, not a technical one.
const DefaultRetention = 14 * 24 * time.Hour

// TTLIndexModel expires a document once retention has elapsed since processedAt but only once processedAt is actually set.
// A *time.Time left nil serialises to an absent field, never a BSON Date, and Mongo's TTL monitor only ever expires Date fields:
// an unprocessed message is safe from deletion by construction.
//
// It must stay a single-field index: expireAfterSeconds is silently ignored on a compound one.
func TTLIndexModel(retention time.Duration) mongo.IndexModel {
	return mongo.IndexModel{
		Keys:    bson.D{{Key: "processedAt", Value: 1}},
		Options: options.Index().SetExpireAfterSeconds(int32(retention.Seconds())),
	}
}
La suppression n’est pas immédiate : un thread de fond, le TTL monitor, balaie la collection toutes les 60 secondes et ne tourne que sur le primary du replica set. Un document qui vient d’expirer attend donc la prochaine passe, potentiellement plus si le primary est chargé. Rapporté à 14 jours de rétention, ce délai est du bruit : la dédup repose sur l’index unique de messageId, pas sur le TTL, donc que la suppression arrive maintenant ou deux minutes plus tard ne change rien au comportement. Contrairement à un cache TTL en Go, où le TTL sert à invalider une entrée à la seconde près, ici il ne sert qu’à libérer de l’espace disque : sa précision n’a aucune importance.
Trois pièges qui ne préviennent pas
expireAfterSecondsest ignoré sur un index composé.
ajouter
(messageId, processedAt)ferait disparaître le TTL sans erreur ni log
- La durée de rétention d’un index TTL déjà créé ne se change pas en relançant
createIndex()avec une nouvelle valeur.
Mongo voit un index identique et ignore la commande.
👉 Il faut passer par collMod pour modifier l’expireAfterSeconds d’un index existant.
- Depuis la version 3.0 de spring data mongo, la création automatique d’index est désactivée par défaut.
@Indexedseul ne crée rien tant queauto-index-creation=truen’est pas activé, ou que l’index n’est pas créé explicitement au démarrage.
Choisir 14 jours n’est pas un choix technique
La rétention doit couvrir la fenêtre maximale pendant laquelle un doublon peut encore arriver, bornée par le plus long de quatre délais :
- la redélivrance après un nack ou un timeout (secondes à minutes),
- la durée de vie d’une dead-letter queue avant rejeu,
- le délai d’un rejeu manuel humain,
- la durée d’une reprise après incident.
Aucune source ne donne de valeur canonique.
14 jours se défend par un argument opérationnel, pas technique.
Un rejeu de DLQ suit souvent le cycle « incident vendredi soir, analyse lundi, rejeu dans la semaine ».
Deux semaines nous donne donc une certaine marge de manoeuvre et ne coûte que du stockage.
Les deux moitiés, face à face
| Outbox (Postgres) | Inbox (MongoDB) | |
|---|---|---|
| Rôle | Publier sans perdre | Consommer sans retraiter |
| Garantit | Le message finit par sortir | Le traitement n’a lieu qu’une fois par clé |
| Ne garantit pas | L’ordre de publication, l’exactly-once | L’idempotence d’un effet hors transaction |
| État vivant | Table outbox, marquée published_at |
Collection inbox, marquée processedAt |
| Purge | Job quotidien après publication | Index TTL sur processedAt |
| Clé pivot | event_id généré à l’insertion |
Le même event_id, reçu comme messageId |
Cette dernière ligne est le vrai point de la série :
la fiabilité se construit en faisant porter les deux moitiés du problème par un seul identifiant, celui de l’événement, pas la clé technique de la table qui l’héberge.
Ressources
- RabbitMQ — Reliability Guide
- RabbitMQ — Consumer Acknowledgements and Publisher Confirms
- MongoDB Manual — TTL Indexes
- MongoDB Manual — Transactions production considerations
- Spring Data MongoDB — Index Creation
- PR DATAMONGO-2477 — Disable auto index creation by default
- The Inbox Pattern in .NET (The Outbox’s Missing Half)